ما هو on-device AI ولماذا يهم الهواتف الحديثة
Introduction
هل لاحظت كيف صار بعض تطبيقات الهاتف “أذكى” فجأة… حتى بدون إنترنت؟ هذا ليس سحرًا، بل تحوّل عملي جدًا في طريقة تشغيل نماذج الذكاء الاصطناعي: بدل ما ترسل بياناتك إلى السحابة وتنتظر الرد، جزء كبير من المعالجة صار يتم على نفس الجهاز. بالنسبة لي كصاحب مدونة تقنية، هذا الموضوع مهم لأنّه يغيّر قواعد الخصوصية والأداء وتكلفة التشغيل للمستخدمين والمطورين معًا. إذا كنت تريد فهم ما هو on-device AI ولماذا يرتبط مباشرة بمفهوم الذكاء الاصطناعي المحلي، فأنت في المكان الصحيح—خصوصًا لو كنت تبني تطبيقًا، تدير موقعًا، أو حتى تبحث عن أدوات تساعدك يوميًا بدون تعقيد.
What You Need to Know
الفكرة ببساطة: بدل تشغيل نموذج الذكاء الاصطناعي على خادم بعيد (Cloud) وإرسال البيانات له، يتم تشغيل النموذج “محليًا” على الهاتف أو الكمبيوتر أو حتى المتصفح—حسب البيئة.
عمليًا، هذا يفتح ثلاث نقاط جوهرية:
- الخصوصية: بياناتك (نصوص، صور، صوت) قد لا تغادر الجهاز أصلًا. هذا فرق ضخم في سيناريوهات مثل: تلخيص ملاحظات شخصية، معالجة صور حساسة، أو اقتراح ردود داخل تطبيق دردشة خاص بالشركة.
- السرعة وتقليل التأخير (Latency): بما أن الاستدلال (Inference) يحدث على نفس الجهاز، فأحيانًا تحصل على نتائج لحظية بدون انتظار الشبكة.
- العمل بدون اتصال: في السفر، أثناء انقطاع الإنترنت، أو في بيئات عمل ذات قيود أمنية، تظل الميزة تعمل.
لكن في المقابل، هناك حدود يجب فهمها: الأجهزة ليست كلها متساوية. هاتف بعتاد قوي (CPU/GPU/NPU) سيعطي نتائج أفضل من جهاز اقتصادي. أيضًا، النماذج الكبيرة جدًا قد تكون غير مناسبة محليًا دون ضغط (Quantization) أو تحسينات.
Tools, Requirements, or Setup Needed
سأقسم المتطلبات حسب الفئة: مستخدم عادي، ومطور/صاحب منتج رقمي. اختر ما يناسبك:
1) للمستخدمين (تجربة الميزات الجاهزة)
- هاتف حديث نسبيًا: الأفضل أن يكون فيه معالج يدعم تسريع الذكاء الاصطناعي (NPU أو TPU على بعض الأجهزة).
- نظام محدث: تحديثات أندرويد مهمة لأنها غالبًا تجلب تحسينات أداء وأمان لمكتبات التعلم الآلي.
- تطبيقات تدعم المعالجة على الجهاز: مثل لوحات مفاتيح تقترح نصوصًا دون إرسالها للسحابة، أو تطبيقات ترجمة/نسخ صوت تعمل جزئيًا أو كليًا دون إنترنت.
2) للمطورين (بناء ميزة AI داخل تطبيق)
- Android Studio + SDK حديث.
- إطار تشغيل نماذج على الجهاز (اختر حسب سيناريوك):
- TensorFlow Lite: شائع جدًا لتشغيل نماذج مضغوطة بكفاءة.
- Google AI Edge / LiteRT (حسب آخر أدوات جوجل المتاحة لديك): لتسهيل تشغيل النماذج على أطراف الشبكة.
- ML Kit: ممتاز لميزات جاهزة مثل OCR، كشف الوجه، مسح النصوص… وغالبًا أسهل في الدمج.
- نماذج مناسبة للأجهزة:
- نماذج مضغوطة (8-bit / 4-bit) أو نماذج صغيرة موجهة للهاتف.
- أداة قياس الأداء:
- Android Profiler، وقياس استهلاك البطارية والذاكرة.
- بدائل اختيارية:
- إن كان هدفك داخل المتصفح: WebGPU/WebAssembly (لكن هذا موضوع منفصل نسبيًا).
- إن كان على سطح المكتب: ONNX Runtime مع تسريع GPU.
Best Time, Use Case, or Situation to Apply This
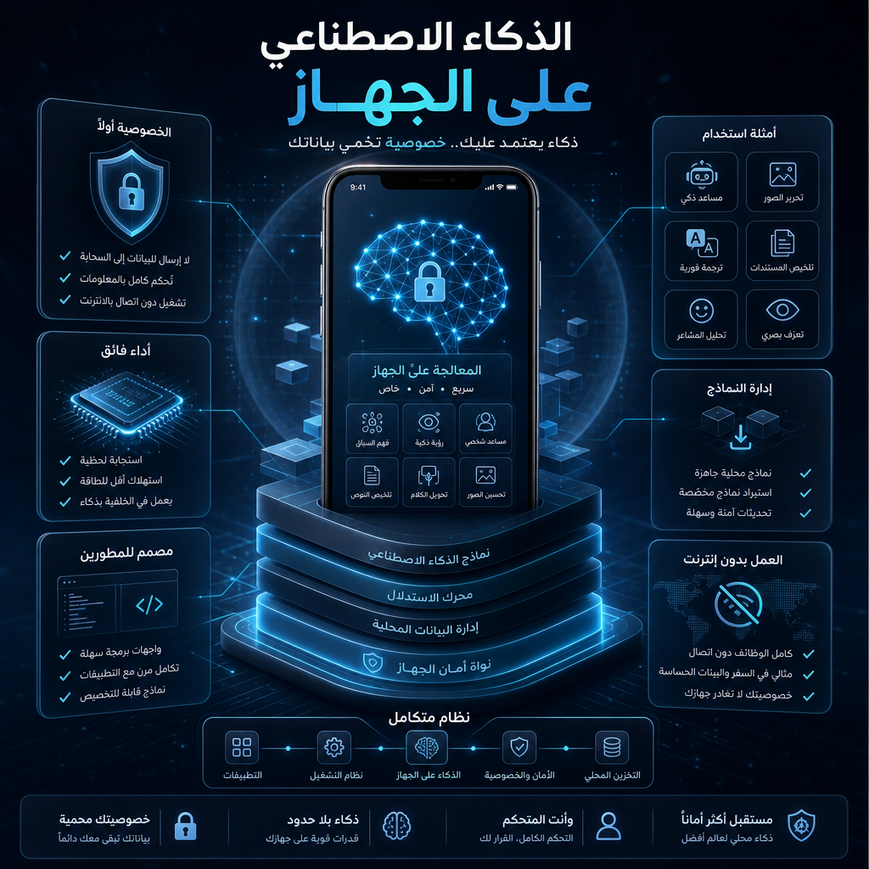
هناك أوقات يكون فيها تشغيل الذكاء الاصطناعي على الجهاز هو القرار “الصحيح” وليس مجرد خيار لطيف:
- عند التعامل مع بيانات حساسة: مثل ملاحظات طبية، صور شخصية، مستندات عمل داخل شركة. كل ما قللت الإرسال للسحابة، قللت المخاطر.
- حين تحتاج استجابة فورية: مثل اقتراحات الكتابة، تصحيح النص، أو ميزة بحث داخل تطبيق بالاعتماد على محتوى محلي.
- للعمل في بيئات اتصال ضعيف: التعليم عن بعد في مناطق تغطية ضعيفة، أو فرق ميدانية تعتمد على أجهزة لوحية.
- لضبط التكاليف: لو كنت مطورًا وتدفع على كل طلب API سحابي، التشغيل المحلي قد يقلل الفاتورة جذريًا (مع الانتباه أن التكلفة تنتقل جزئيًا إلى تعقيد التطوير والتحسين).
- عندما تريد “وضع طيران” فعلي للذكاء: بعض التطبيقات تعدك بالعمل دون إنترنت، لكن الميزة تنهار عند انقطاع الشبكة. هنا التشغيل المحلي يصنع الفرق.
Step-by-Step Guide or Main Explanation
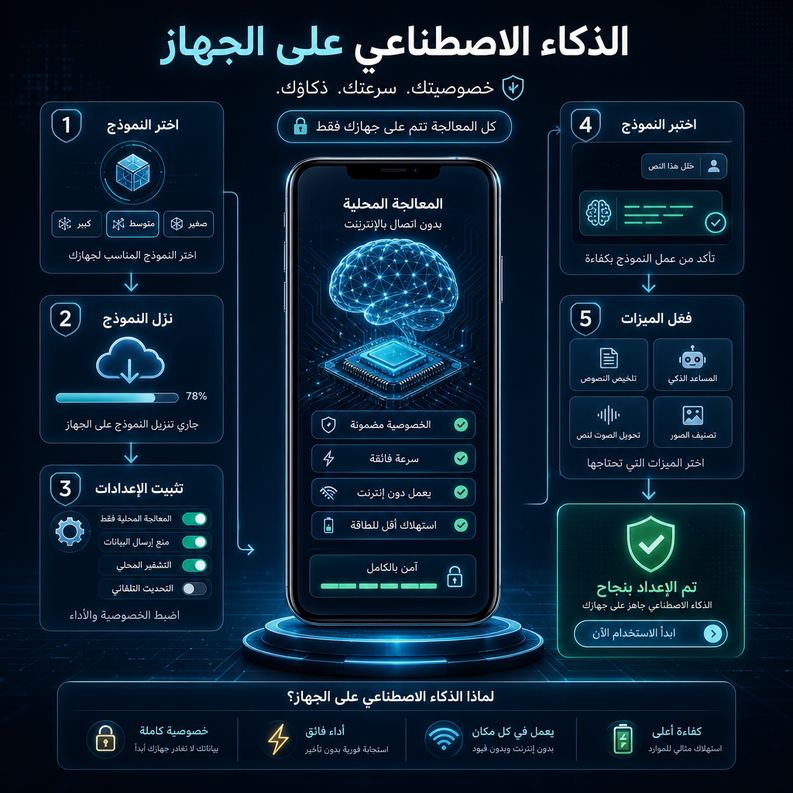
سأشاركك طريقة عملية أفكر بها عندما أريد إضافة ميزة ذكاء اصطناعي تعمل على الجهاز داخل تطبيق (أو حتى تقييم ميزة جاهزة). وخلال ذلك ستفهم بشكل تطبيقي ما هو on-device AI وكيف يترجم فعليًا إلى الذكاء الاصطناعي المحلي على أندرويد.
الخطوة 1) حدّد المهمة بدقة قبل اختيار أي نموذج
اسأل نفسك: هل تريد تلخيص نص؟ تصنيف صور؟ تحويل صوت إلى نص؟ نصيحتي: لا تبدأ بالنموذج، ابدأ بالمهمة—لأن كل مهمة لها نماذج وأحجام مختلفة.
تحذير عملي: استخدام نموذج عام كبير لمهمة بسيطة غالبًا يعني بطء + استهلاك بطارية + تجربة سيئة.
الخطوة 2) قيّم قدرات الأجهزة المستهدفة
- ما الحد الأدنى من الأجهزة التي تدعم تطبيقك؟
- هل عندك جمهور بهواتف اقتصادية؟
- هل تحتاج تسريع عبر NPU/GPU؟
أفضل ممارسة: ضع “خطة بديلة” (Fallback). مثلًا:
- تشغيل محلي للأجهزة القوية
- وخيار سحابي اختياري لمن يوافق على ذلك (مع سياسة خصوصية واضحة)
الخطوة 3) اختر المسار: ML Kit أم TFLite أم حل آخر؟
- إن كنت تريد نتائج بسرعة وبأقل كود: ML Kit ممتاز.
- إن كنت تريد تحكم كامل + نموذج مخصص: TensorFlow Lite أفضل.
- إن كنت تعمل على نموذج لغوي صغير على الجهاز: تأكد من دعم الصيغة، الضغط، وواجهة الاستدلال.
نصيحة: جرّب أولًا نموذجًا جاهزًا صغيرًا لتتأكد أن التدفق كامل يعمل، ثم حسّن الجودة لاحقًا.
الخطوة 4) حضّر النموذج للأجهزة (Optimization)
هذه أكثر نقطة تفرق معي في الأداء:
- استخدم Quantization لتقليل الحجم وتسريع الاستدلال.
- انتبه لحجم النموذج النهائي داخل التطبيق (APK/AAB).
- اختبر الذاكرة: بعض الأجهزة تنهار بسبب ضغط RAM وليس CPU.
ملاحظة مهمة: لا تقِس الأداء على هاتفك فقط. اختبر على جهاز متوسط على الأقل.
الخطوة 5) نفّذ الاستدلال بدون تجميد واجهة المستخدم
- لا تشغل الاستدلال على الـ Main Thread.
- استخدم Workers/Coroutines/Executors حسب أسلوبك.
- اعمل “تقطيع” للمدخلات إذا كانت طويلة (مثل نصوص كبيرة).
علامة خطر: لو لاحظت تقطيع بالواجهة أو ارتفاع حرارة سريع، فأنت تحتاج تحسينًا أو تخفيفًا للحمل.
الخطوة 6) تعامل بذكاء مع الخصوصية والتخزين
حتى لو المعالجة محلية، قد تخرب الخصوصية إن خزّنت:
- النصوص الأصلية
- التسجيلات الصوتية
- السجلات (Logs) التي تحتوي محتوى المستخدم
أفضل ممارسة:
- قلّل التسجيلات، وفعّل وضع “حذف تلقائي” للبيانات المؤقتة.
- شفّر التخزين إن اضطررت للاحتفاظ بأي شيء.
الخطوة 7) اختبر الجودة + الأداء + البطارية
اختبر 3 أشياء معًا:
- الدقة/الجودة: هل النتائج مفيدة فعلًا؟
- زمن الاستجابة: هل المستخدم ينتظر كثيرًا؟
- استهلاك الطاقة: هل البطارية تنهار بعد 10 دقائق؟
تلميح صغير: ضع قياسًا داخل التطبيق (Telemetry) لكن بدون بيانات حساسة، فقط أزمنة وقياسات عامة—لتعرف أين تحتاج تحسينًا.
Benefits and Importance
من تجربتي، القيمة الحقيقية هنا ليست “ترند” الذكاء الاصطناعي، بل نتائج مباشرة يلاحظها المستخدم وصاحب المنتج:
- خصوصية أعلى واقعية: تقليل مشاركة البيانات مع خوادم خارجية يقلل سطح الهجوم ويبسّط الامتثال (خصوصًا للشركات).
- أداء أسرع في سيناريوهات كثيرة: خصوصًا للمهام الخفيفة والمتوسطة.
- استمرارية العمل دون إنترنت: هذه ميزة “تُباع لوحدها” إن كان تطبيقك يستهدف سفر، تعليم، أو فرق ميدانية.
- خفض التكاليف التشغيلية: تقليل طلبات API السحابية قد يغيّر اقتصاديات المنتج بالكامل.
- تجربة مستخدم أكثر سلاسة: عندما تتم المعالجة محليًا بشكل صحيح، المستخدم يشعر أن التطبيق “يفهمه” فورًا.
Extra Tips, Best Practices, and Alternatives
هذه نقاط إضافية أطبقها دائمًا لأنها توفر وقتًا ومشاكل لاحقًا:
- ابدأ بنموذج أصغر مما تعتقد: غالبًا النموذج الأصغر يكفي 80% من الجودة المطلوبة مع 20% من التكلفة.
- اعتمد سياسة “جودة تدريجية”: أعطِ نتيجة سريعة أولًا، ثم حسّنها في الخلفية إن احتجت.
- نفّذ Cache ذكي للنتائج غير الحساسة: مثل نتائج تصنيف ثابتة، لتقليل إعادة الاستدلال.
- بدائل هجينة (Hybrid):
- محلي للمهام السريعة/الحساسة
- سحابي للمهام الثقيلة أو عند طلب المستخدم جودة أعلى
- ركّز على تجربة الإعداد: اسمح للمستخدم بإيقاف الميزة أو اختيار “محلي فقط” إن كان يهتم بالخصوصية.
Common Mistakes to Avoid
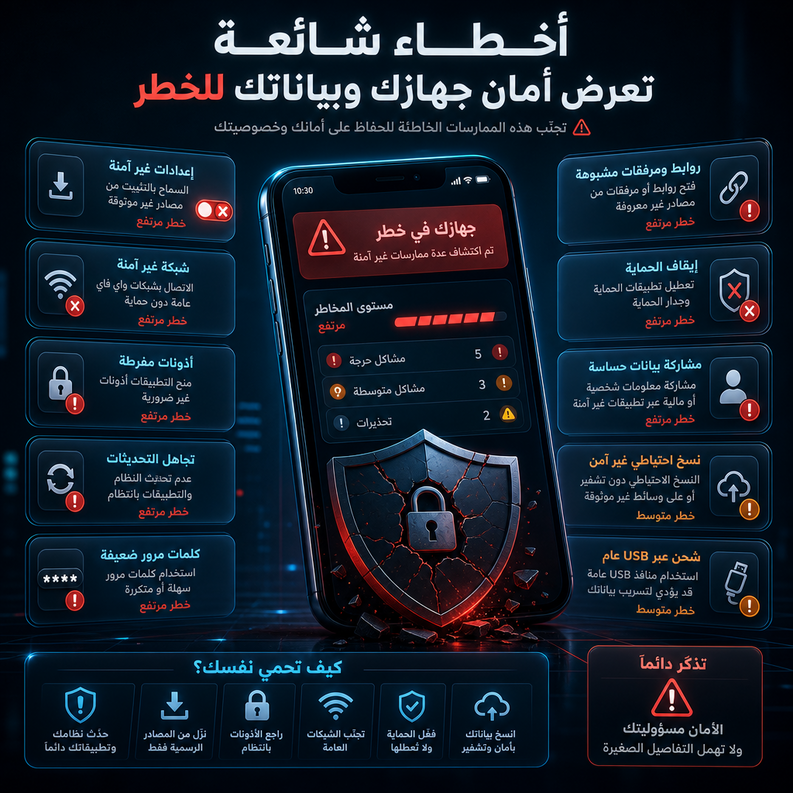
هذه أخطاء رأيتها كثيرًا (وبعضها وقعت فيه بنفسي سابقًا):
- اختيار نموذج ضخم بلا سبب
الحل: ابدأ صغيرًا، ثم قارن الجودة بالأرقام (Latency/Memory/Accuracy).
- تشغيل الاستدلال على الواجهة مباشرة
الحل: انقل الاستدلال لخلفية التطبيق، وراقب الـ ANR.
- نسيان الأجهزة الضعيفة
الحل: اختبر على جهاز متوسط/ضعيف، وضع وضع توفير (Lite mode).
- الاعتماد على “محلي” ثم تخزين بيانات حساسة في Logs
الحل: نظّف السجلات، وفعّل Redaction، وتأكد أن التحليلات لا تجمع محتوى المستخدم.
- عدم وجود خطة فشل
الحل: عندما يفشل النموذج (ذاكرة/وقت/عدم دعم)، اعرض بديلًا منطقيًا بدل كسر الميزة.
Long-Term Improvement Tips
للحصول على نتائج أفضل مع الوقت، اتبع هذا الأسلوب المستمر:
- راقب الأداء بعد الإطلاق: ليس بالأرقام العامة فقط، بل حسب فئات الأجهزة.
- حدّث النماذج تدريجيًا: بدل قفزات كبيرة، اعمل تحسينات صغيرة واختبر تأثيرها.
- ابنِ مكتبة اختبارات داخلية: مجموعة نصوص/صور قياسية تختبر عليها كل نسخة لتضمن أن الجودة لم تتدهور.
- استثمر في الضغط والتحسين: quantization، pruning، وتقليل المدخلات—هذه تعطي نتائج “هائلة” بدون تغيير تجربة المستخدم.
- كن واضحًا مع المستخدم: أعطه خيار التحكم (تشغيل/إيقاف/محلي فقط) وفسّر الفائدة ببساطة داخل الإعدادات.
Conclusion
بعد كل هذا، الصورة التي أريدك أن تخرج بها بسيطة: عندما تفهم ما هو on-device AI بشكل صحيح، ستبدأ تنظر للذكاء الاصطناعي كميزة يمكن تشغيلها بكفاءة وخصوصية على جهاز المستخدم، وليس كخدمة سحابية إجبارية. وهذا بالضبط جوهر الذكاء الاصطناعي المحلي: تجربة أسرع، بيانات أقل خروجًا من الجهاز، واعتماد أقل على الشبكة. جرّب تطبيق فكرة واحدة مما ذكرت—حتى لو كانت صغيرة مثل نقل الاستدلال للخلفية أو اختيار نموذج أخف—وستلاحظ فرقًا مباشرًا في الأداء وتجربة المستخدم.
FAQs
1) هل تشغيل الذكاء الاصطناعي على الجهاز يعني خصوصية 100%؟
ليس دائمًا. المعالجة قد تكون محلية، لكن الخصوصية تتأثر أيضًا بما يخزنه التطبيق، وما يرسله للتحليلات، وكيف يدير السجلات. الفكرة تقلل المخاطر، لكنها لا تلغيها بدون تصميم صحيح.
2) هل كل الهواتف تدعم تشغيل نماذج AI محليًا بكفاءة؟
كل الهواتف “تستطيع” بدرجات متفاوتة، لكن الكفاءة تختلف جدًا حسب المعالج والذاكرة ووجود NPU. لذلك من المهم وضع وضع خفيف واختبارات على أجهزة متعددة.
3) ما الفرق العملي بين الحل المحلي والحل السحابي؟
المحلي أسرع غالبًا في الاستجابة القصيرة ويحسن الخصوصية ويعمل دون إنترنت، بينما السحابي يتيح نماذج أكبر وجودة أعلى في بعض المهام لكنه يعتمد على الشبكة ويزيد التكاليف التشغيلية.
4) كم مرة يجب أن أحدّث النموذج داخل التطبيق؟
يعتمد على المنتج. إن كانت المهمة حساسة للجودة (مثل التلخيص أو التصنيف)، راجع الأداء دوريًا. كثير من الفرق تعتمد تحديثات ربع سنوية أو عند توفر تحسين واضح مع الحفاظ على حجم مناسب.
5) ما أول خطوة أنصح بها مطورًا يريد البدء بسرعة؟
ابدأ بـ ML Kit إن كانت ميزتك ضمن قدراته (مثل OCR أو تحليل الصور)، أو بنموذج TFLite صغير جدًا لمهمة محددة. الهدف الأول ليس “الأفضل”، بل “نسخة تعمل” تقيس عليها الأداء والجودة.